上一篇记的是把这套 PVE + RouterOS 的 VPS 自助开通系统搭起来的过程。系统能跑了,但"能不能搬到别的机器上"是另一个问题——一个只有原作者会部署的系统,不算真正交付。这篇把迁移需要的依赖、顺序、验收标准整理清楚,同时把我在"搬"这件事上真踩过的三个坑写下来。其中第一个,把宿主机上的生产数据库整个清空了。
*
一、先回答最常被问的那个问题:要不要装"面板"
不用。这套系统的"面板"就是自己写的那份代码——/opt/vps 一个目录,加一个 systemd 服务,监听 8080。它直接指挥虚拟化层干活,中间没有中间商,所以不需要 SolusVM、Virtualizor、WHMCS 那一类东西。
但有一个硬约束必须先说清楚:
底座必须是 Proxmox VE,不能是裸 KVM / libvirt。
原因是 vpsctl.py 里 44 处直接调 qm(PVE 的命令行),另外还有 pvesm、qemu-img。这些是 PVE 自己的封装,裸 KVM 上没有。真要上裸 KVM,得把这一层全部重写成 virsh / qemu 直调,顺带还要自己做「模板克隆、cloud-init 注入、磁盘扩容、快照」这些 PVE 已经替你做完的事,成本不划算。
顺带说一句:PVE 本身就带 Web 管理面板(https://IP:8006),所以从"能管虚拟机"这个角度,你本来就是有一个面板的,我们要加的只是它上面那层业务。
二、依赖清单:三层,只有中间一层要你动手
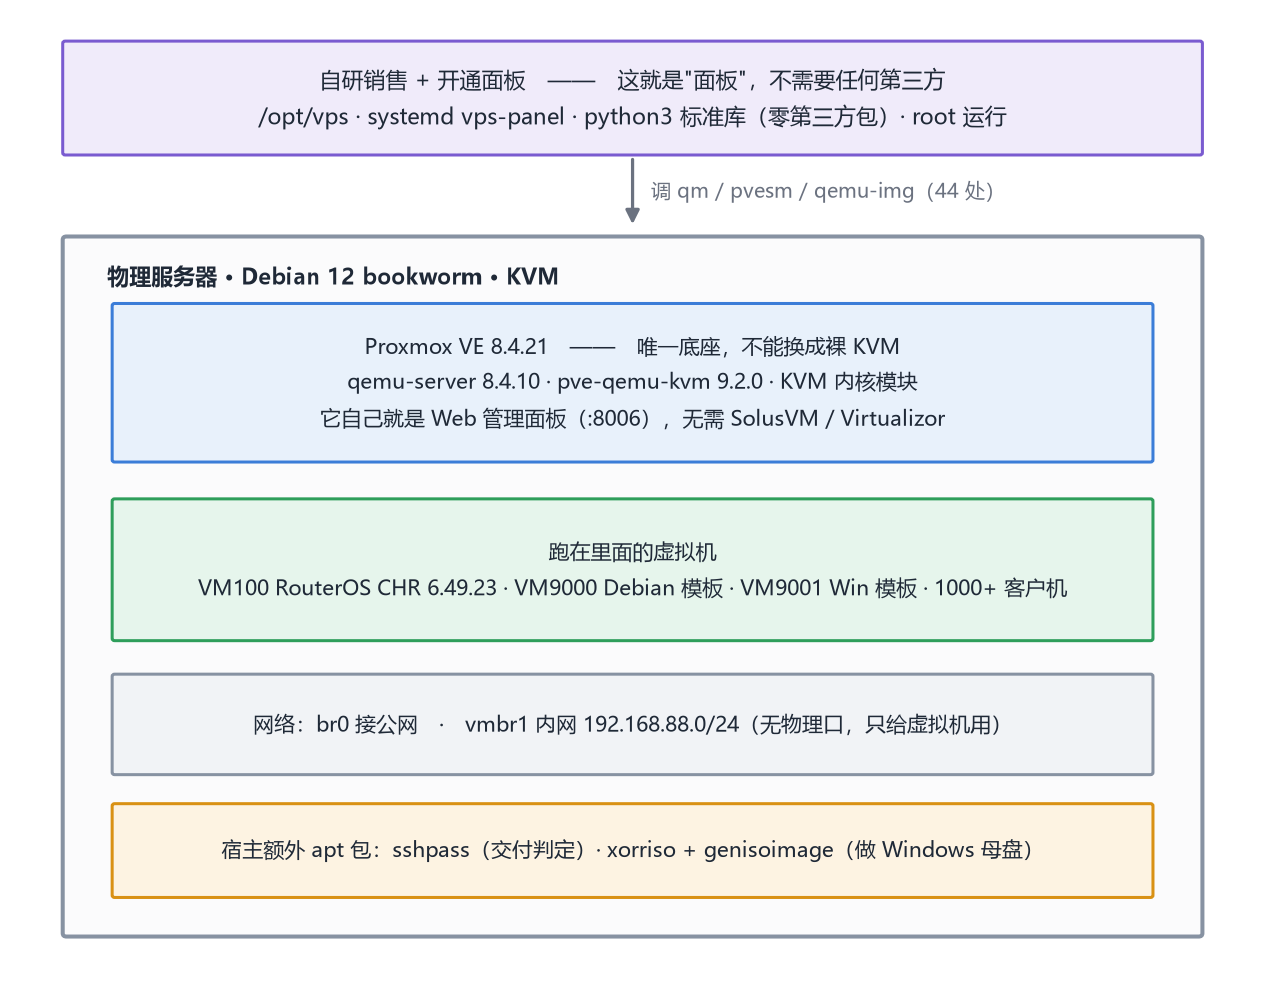
第一层,底座。 Debian 12 + Proxmox VE 8.x(当前是 8.4.21),带 qemu-server 8.4.10、pve-qemu-kvm 9.2.0 和 KVM 内核模块。用 PVE 官方 ISO 装最省事,或者在 Debian 12 上按官方文档加 PVE 源。
第二层,宿主机上额外要装的 apt 包——就这几个,没有更多:
sshpass:交付判定要用它真的用密码 SSH 登一次,不能用"端口开着"代替xorriso+genisoimage:构建 Windows 母盘时做软盘镜像和辅助光盘wimlib-imagex:备用,当前流程没直接用到
apt install -y sshpass xorriso genisoimage wimlib-imagex其余的命令(qm / pvesm / qemu-img / ip / curl / wget / sqlite3)随 PVE 或 Debian 自带,不用管。
第三层,业务运行时(不是 apt 包,是要建的东西):RouterOS CHR 虚拟机、两个金镜像模板、两张网桥。
明确不需要的东西,列出来比列需要的更有说服力:
- ❌ 任何 Python 第三方包。控制端 100% 标准库(
http.server/sqlite3/hashlib/socket…),没有 Flask、没有 paramiko。我用语法树扫过一遍确认,第三方依赖为空。 - ❌ Nginx / Apache。面板自带
http.server直接监听 8080。要上 HTTPS 再另外加反代。 - ❌ MySQL / PostgreSQL。存储是 SQLite 单文件。
- ❌ Node.js 或任何前端构建工具。页面是纯静态 HTML。
三、包里没带、要另外准备的五个大件
迁移包里装的是代码和脚本,下面这些体积大、有授权或来源要求的东西得自己备:
- PVE 安装 ISO(约 1.5 GB)——装底座
- Debian 12 通用云镜像(约 350 MB)——烘焙模板 9000,
build_template2.sh会校验 SHA512 - Windows Server 2019 官方 ISO(5.2 GB)——烘焙模板 9001,必须用官方盘,别用网上流传的 DD 镜像
- virtio-win.iso(约 700 MB)——只为从里面取
vioserial驱动,这是 Windows 客户机唯一必须注入的 virtio 驱动 - RouterOS CHR 镜像(64 MB)——
chr-6.49.23.img,做 VM100
四、六步落地
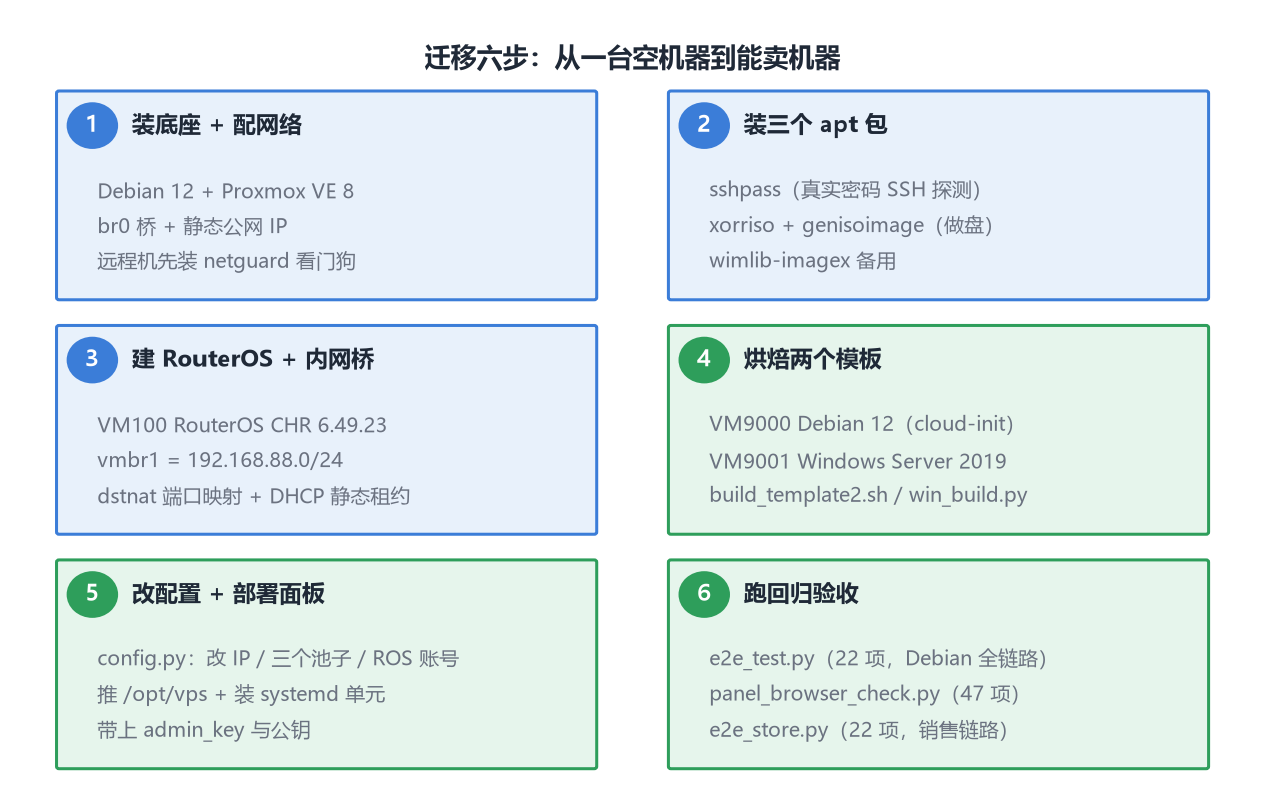
第 1 步:装底座 + 配网络。 Debian 12 + PVE 8,配 br0 桥接和静态公网 IP。这里有个只在这类"无带外通道"的机器上才成立的前提——改网络之前先装好看门狗(我这边用的是自写的 netguard 服务),否则 /etc/network/interfaces 一配错就直接失联,而这台机器没有 IPMI、没有 VNC,救不回来。
第 2 步:装那三个 apt 包。 就上一条命令。
第 3 步:建 RouterOS + 内网桥。 VM100 跑 RouterOS CHR,网卡桥到 br0 拿 WAN,另一条腿桥到内部网桥 vmbr1 做 LAN。端口映射(dstnat)和 DHCP 静态租约都在它身上。vmbr1 特意不挂物理口,只给虚拟机用。
第 4 步:烘焙两个模板。 Debian 走 build_template2.sh,Windows 走 win_build.py。这一步最慢也最容易出岔子,Windows 母盘从零到能用大概要小一个钟头。
第 5 步:改配置 + 部署面板。 所有可调参数都集中在 config.py 一个文件里,换机器只需改它:公网 IP、三个资源池(VMID / 内网 IP / 公网端口)、RouterOS 的地址和账号、模板 VMID。改完推 /opt/vps,装 systemd 单元。别忘了把 admin_key 和 admin_key.pub 一起带过去——它既是免密登录工具,也是灾难恢复时唯一能把客户机密码找回来的手段。
第 6 步:跑回归验收。 三个套件,见下面第六节。
五、三个真踩过的坑
三个坑有个共同点,先说结论:都不是"逻辑写错了",而是"接口约定没对齐"——文件名、枚举值、返回值语义。它们在前端回归里全都测不出来,只有跑一次真实动作才会暴露。
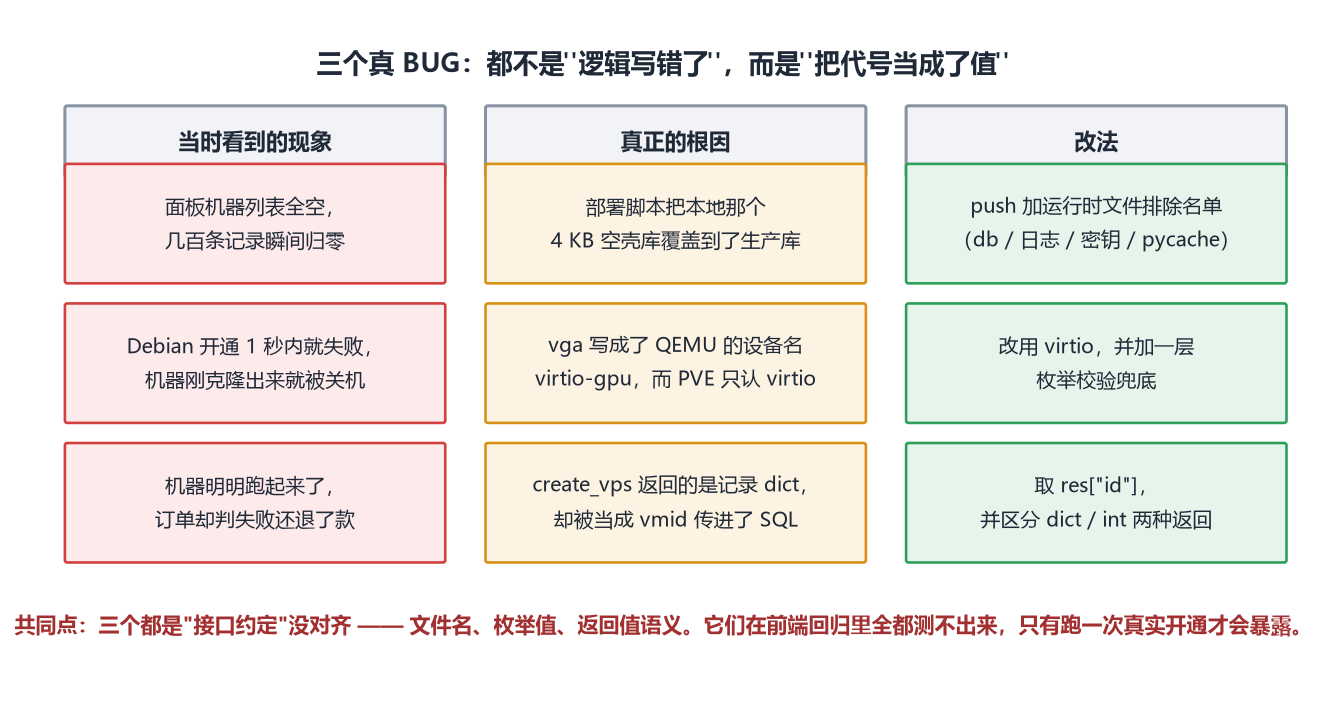
坑一:部署脚本把生产库清空了
现象:面板一刷新,机器列表全空,几百条记录瞬间归零。
排查:好在部署前顺手 cp 了一份数据库备份。一看那个备份文件——4096 字节,而且 sqlite_master 里一张表都没有。也就是说,备份的那个时刻,主库就已经是个空壳了。
顺着往下查,根因是这个:
- 源码目录里曾经跑过一次自检脚本,
SQLite连接时顺手在源码目录建了一个空的vps.db(4 KB,没表) - 而部署脚本干的事是"整个目录推上去"
- 于是每次部署,都在把宿主机上那个活库覆盖成空壳
改法:给部署脚本加了运行时文件排除名单,白名单式的思路反过来用:
SKIP_DIRS  = {"__pycache__", ".git", ".stage", "node_modules", ".workbuddy"}
SKIP_FILES = {"vps.db", "vps.db-wal", "vps.db-shm", "vps.log",
              "admin_key", "admin_key.pub"}
SKIP_SUFFIX = (".pyc", ".pyo")
vps.db 是数据、vps.log 是日志、admin_key 是私钥——这三类都不该被覆盖,也不该被上传。顺手把源码目录里那个空壳也删了,从源头断掉。
恢复:数据没了,但系统还在——这是个关键判断。因为同一份事实在三处留了痕,可以互相印证:
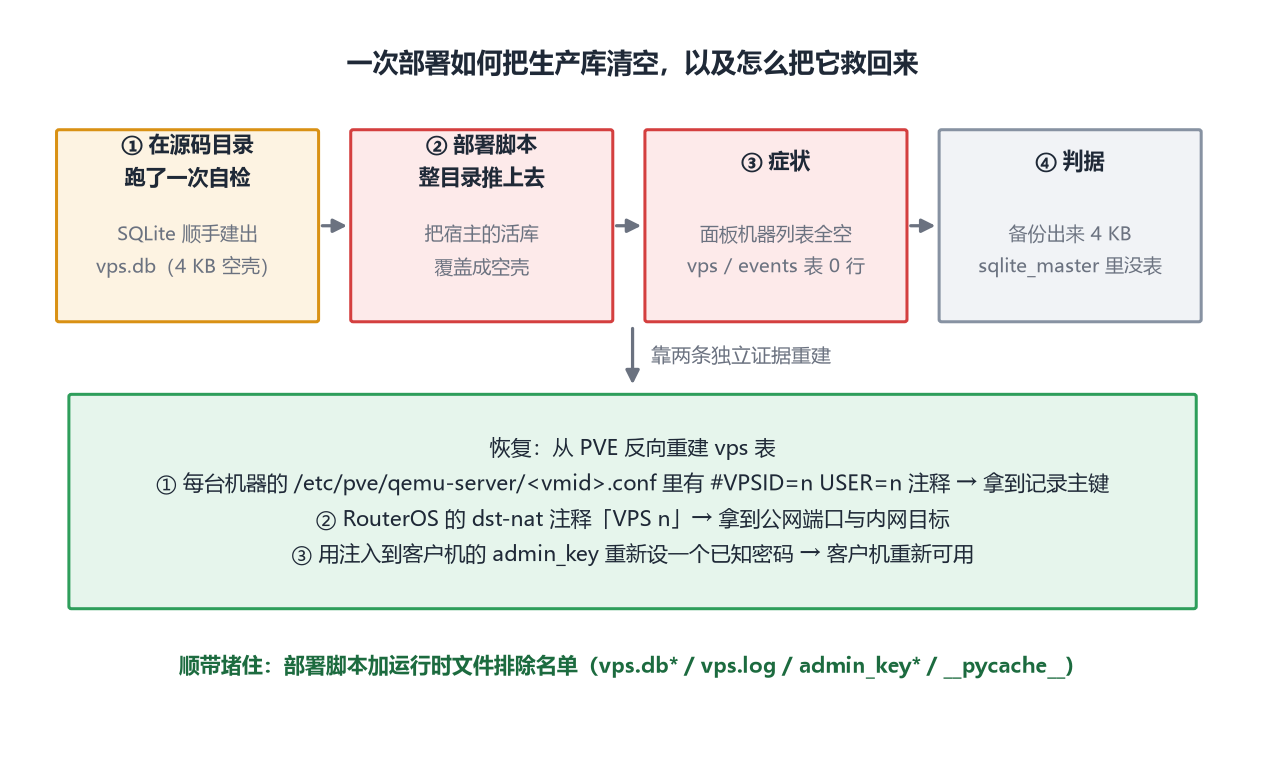
- 每台机器的 PVE 配置里,有开通时写进去的
#VPSID=n USER=n注释,直接给出了原来的记录主键 - RouterOS 的 dst-nat 规则注释里有「VPS n」,给出了公网端口和内网目标地址
- 内网 IP、MAC、CPU/内存/磁盘规格,PVE 配置里全都有
vps 表重建出来,再用注入到客户机的 admin_key 重新设一个已知密码——两台机器都原地复活,客户机里的数据一点没动。
最值钱的一条经验:数据库不是唯一的真相来源。虚拟化层和网络层各自持有一份"设备事实",只要它们还在,业务记录就能反推。但这要求开通的时候就把关联信息写进那里——#VPSID=n 这种注释平时看着多余,出事的时候就是救命的那行字。
坑二:一个参数名写错,开通 100% 失败
现象:Debian 机器下单后 1 秒内就失败,刚克隆出来的虚机立刻被关机回收。
根因:我把 vga 参数写成了 virtio-gpu。
这个值是 QEMU 的设备名,但 qm set --vga 走的是 PVE 自己的枚举:
cirrus | qxl | qxl2-4 | none | serial0-3 | std | virtio | virtio-gl | vmware里面没有 virtio-gpu。所以 qm set 直接返回 400:
400 Parameter verification failed.
vga.type: value 'virtio-gpu' does not have a value in the enumeration ...要命的是这个错不会让整条流程体面地失败——它埋在 PVE 的参数校验里,日志上只看到"开通失败",一眼看不出是哪个参数。而且前端回归测不到它,因为前端回归不真的开机器。
改法:改成 virtio,并加了一层取值收敛,任何不在枚举里的值都退回 std,绝不把非法值喂给 qm。另外把母盘构建脚本里同名的错误也一并改了——那份如果跑起来,模板会直接烘焙失败。
教训:改开通参数,必须跑一次真实开通。 这个坑我上一轮就埋下了,当时因为只跑了前端回归和页面检查,它安安静静躺了一整轮才发作。凡是"参数透传到外部系统"的地方,本地测试永远测不完整。
坑三:把返回值当成了 ID
现象:机器明明开好了、跑起来了,订单却判失败、钱也退了——等于白送一台机器。
根因:create_vps() 返回的是整条 vps 记录的 dict,我在销售层却当成整数 ID 用:
vid = vpsctl.create_vps(...)     # 返回 dict
vpsdb.update_order(order_id, vps_id=vid)   # dict 一路进了 SQL 参数
SQLite 直接报:
Error binding parameter 1: type 'dict' is not supported异常被外层的 except 接住,走退款 + 标记订单失败。但异常发生时,机器已经开好了。
改法:取 ID 的时候把两种返回都处理掉:
res = vpsctl.create_vps(...)
vid = res["id"] if isinstance(res, dict) else int(res)这个坑的危险性在于它不会报错——它会安静地"成功失败"。系统认为订单失败了,用户却拿到了一台正在运行的机器。凡是"扣了钱又要退钱"的分支,都值得单独跑一遍验证。
六、迁移后的验收清单
迁移最容易糊弄的地方就是验收——"页面能打开"不等于"系统能用"。这套系统有三层验证,判据全部是真实业务动作:
e2e_test.py(22 项) —— 登录 → 开通 → SSH 真实密码登录 → 关机/开机/重启/重装 → 销毁。这一套验的是底层开通引擎。panel_browser_check.py(47 项) —— 用无头浏览器真实点一遍面板:登录、渲染机器卡片、打开 VNC 监控、判定画布上出现非黑像素、拖动窗口、密码显示/复制、各操作的二次确认弹窗。这一套验的是前端交互。e2e_store.py(22 项) —— 建支付方式 → 提交充值申请 → 人工确认入账 → 算价 → 下单扣款 → 自动开通 → 订单回填 → 续费扣款 → 到期顺延 → 删除回收。这一套验的是销售链路。
两条我认为不能省的判据,列出来备查:
- SSH 交付判定必须是"用密码真的登进去",不是"22 端口通"。端口通只能说明 NAT 建好了,客户机里的 sshd 可能压根没起来。
- VNC 判定必须是"画布上出现非黑像素",不是 noVNC 的
connect事件。后者只代表 RFB 握手完成,第一帧还没到,此时截图必然是黑底。
七、最后:迁移这件事的三条经验
- "能跑"和"能搬"是两件事,后者需要显式的清单。 这套系统我写得很自包含(全标准库、配置集中在一个文件),但如果不是把依赖清单和顺序写下来,半年后我自己搬第二台机器照样会漏东西——事实也确实漏了,漏的那一项把数据库清空了。
- 部署脚本要有边界。 把"运行时会生成的文件"和"要部署的代码"混在一个目录里,是这类事故的温床。数据、日志、密钥这三类文件,永远不要参与"整目录同步"。
- 每个关键动作都要在别处留下可反推的痕迹。
#VPSID=n是随手写的注释,RouterOS 规则的「VPS n」也只是为了好认。但它们共同构成了一张跨系统的对账网——当中心化的数据库出问题时,只有这种东西能把你捞回来。
相关:上一篇《PVE + RouterOS CHR 自建 VPS 自助开通系统:从 Web 开户到 Debian / Windows 双系统交付全记录》记录了这套系统从零搭起来的过程,包括 cloud-init 不给 root 留门、一次硬关机把客户机 sshd 写死、以及微软官方安装盘 UDF 那堵墙。
本文只讲方法与依赖,不含任何服务器凭据、口令或密钥。
💬 评论 (5)