2026-10-02 一整天都在跟同一个策略较劲:一个 ETF 动量轮动策略的 QMT 实盘版和离线回测版。本来只想核对一下"实盘跑得对不对",结果一层层扒下去,最后扒出一个影响所有历史结论的口径问题。这篇把思路和结论按顺序记下来,含全部测试截图。
一、这一天的起点:一句"收益感觉对不上"
策略本体是一个 ETF 动量轮动:145 只 ETF 池,动量选 top-3,波动率加权、相关性去重、-20% 回撤熔断。跑两条轨:
- 实盘轨:QMT(国信 iQuant)里的 30 分钟事件驱动版,每根 30 分钟 bar 评估一次,
|Δw| ≥ 1%才动手; - 研究轨:本地离线回测引擎,用买的 zip 分钟数据(2020 年起)和国信本地库(只有 2025 年起)两套源。
二、第 1 站:QMT 回测跑得对不对?——程序没错,但没达到设计预期
先把 7000+ 行日志和 1600 多笔成交记录读了一遍,统计各类事件:
- 7212 行日志、1787 次评估,零程序错误、零取数异常;
- T+1 闭环正常:当日买入被拦 832 次,跨日解禁后能正常卖出;
- 熔断未触发(日志里那唯一一处"熔断"字样只是初始化打印);
- 波动率缩放生效 398 次,信号在正常轮换。
- 有效区间只有 11 个月:首笔成交在 2025-11-03,因为本地 1 分钟数据大约是那时才补齐的。所以离线口径"2020-2026 净值 5.647"这一轮根本对照不了;
- 交易费用全是 0:需要在 QMT 回测设置界面配佣金,代码里改不了;
- 调仓频率是离线的 2 倍:触发率 65.5%,而离线约 33%。根因是权重对比口径——实盘用"当前市值权重"(随价格漂移),离线用"上次目标 vs 新目标"。
end_time 的调用一旦为空,会静默退到不带 end_time 的调用——在 QMT 回测里这就等于读未来数据。那一轮没触发,但属于概率性隐患。
三、第 2 站:按优先级修 + 提速,然后自己被自己的修复绊了一下
修复清单(改的是策略文件,原版先备份):
- P0 前视漏洞:删掉"无
end_time兜底",取不到数就跳过,绝不放开未来数据; - P1 触发口径:改成「参考权重 vs 新目标」逐只滞回,与离线引擎一致。这一步把调仓次数从 1170 压到 985;
- P2 资金处理:买入按「现金 + 卖出所得」整体等比缩放,不再逐笔缩量硬买;
- P2 净值打印:每天首根 bar 打印总资产/NAV/回撤。
- 分钟历史按日缓存 + 当日增量取数(每根 bar 只拉新增的几十根,不再重拉 3600 根 × 145 只);
- 日线按日缓存(一次取 130 根,覆盖波动率与相关性两个用途);
- 去重池每天只算一次(原来每根 bar 对 145 只各调一次取数 API,这是最大耗时点);
- 均线用前缀和 O(1)。
然后上机第一跑就崩了,每根 bar 都报:
ZeroDivisionError: float division by zero
  File "<string>", line 736, in build_dedup_pool
File "<string>", line 686, in get_returns查下来是我自己引的新 bug:
QMT 的 get_market_data_ex 在请求根数超过标的真实历史时,会用 0 补齐前面的行,而不是只返回现有的根数。
- v1 的相关性去重每次只取 122 根日线,恰好没碰到补零区,所以跑了 11 个月从没炸过;
- v2 的日线缓存改取 130 根,池子里那些 2025 年新上市、历史不满 130 天的 ETF,多出来的行全是 0;
- 0 进收益率序列
cl[i]/cl[i-1],就是除零。
close<=0 与 NaN 的无效行,过滤后历史不足窗口根数的标的由长度检查自然跳过——这才是正确语义(上市不满 15 天动量窗口的标的本来就不该有信号)。同时在桩测试里专门注入补零行验证,输出与干净数据完全一致。
四、第 3 站:逐笔对账,和本地回测到底差在哪
用"成交 CSV 现金流重放 + 期末按本地价盯市"的方式重建了 QMT 那轮的净值,再和本地 zip 回测逐日、逐笔比。
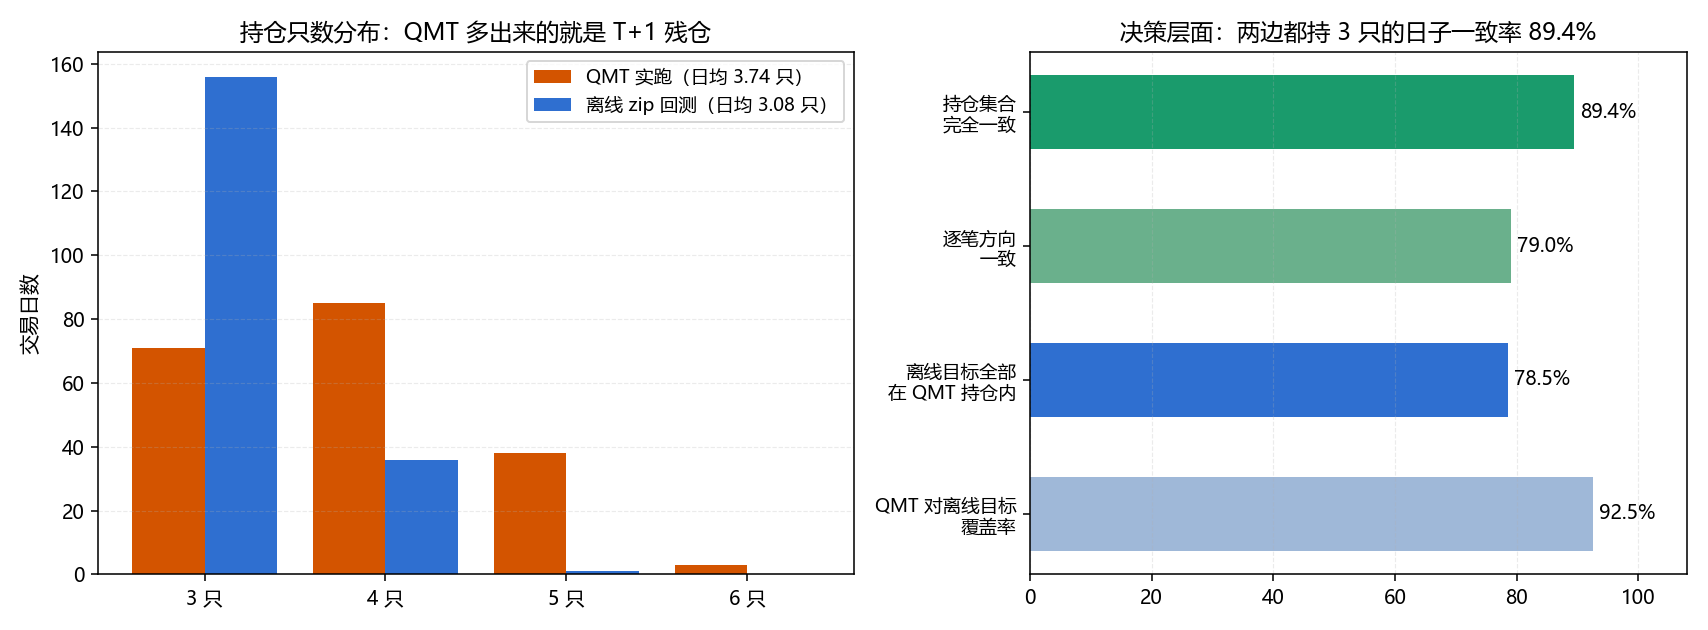
先看一个容易误导人的数字:逐日持仓完全一致只有 37.3%。但拆开看原因就清楚了——QMT 日均持 3.74 只,离线 3.08 只,多出来的是 T+1 残仓(当天买的当天卖不掉,收盘必然多挂 1~2 只),集合当然对不上。
用公平口径重新比:
- 两边都恰好持 3 只的 66 个交易日里,持仓完全一致 59 天 = 89.4%;
- 离线目标持仓全部落在 QMT 实际持仓内的天数:78.5%;
- QMT 持仓对离线目标的平均覆盖率:92.5%;
- 期末持仓完全相同。
收益差的拆解(同窗口,都是免佣):
- QMT 账户(日志口径)净值 1.2752;
- 同一串成交、期末按本地价盯市 → 1.2573(差 +1.8pp,全是期末 3 只 QDII 的估值价差);
- 同一串成交、全程按本地价 → 1.2590(价格数据本身对同一串成交只影响 +0.17pp);
- 离线引擎自身交易 → 1.3080(与同口径差 -3.2pp = 交易序列差异)。
五、第 4 站:2025 年收益"差"的真凶——不是策略,是数据缺员
这一站的结果最直观:同一年、同一策略,四个口径差 24 个百分点。
- 本地 zip(购买数据,全历史):+50.6%
- zip 数据但剔除 3 只缺数据标的:+42.3%
- QMT 实跑:+35.1%
- 国信 datadir:+26.1%
- 2025 年 1~10 月,国信库能满足"3602 根分钟历史"、可参与选股的只有 99~105 只 / 145;
- zip 同期是 132 只 / 145;
- 到 2025-11 突然补齐到 145 只。
消融实验验证:把这三只从 zip 口径的池子里剔掉,2025 收益从 +50.6% 掉到 +42.3%(-8.3pp)——仅这一项就解释了 QMT 与 zip 差距的一半以上。
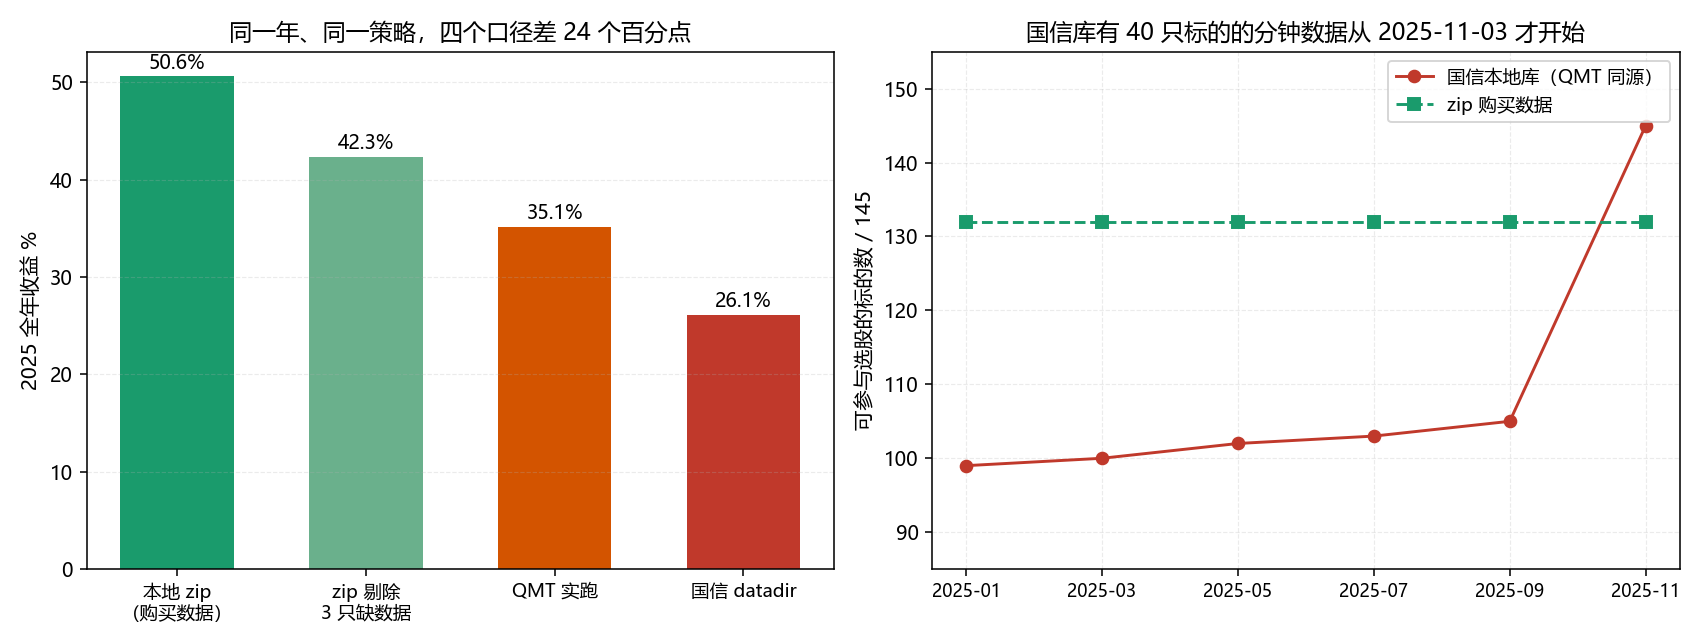
结论:在这种数据条件下,QMT 与 zip 的回测本来就不可比。用同一套 zip 数据是 +50.6%,用缺员的国信库是 +26~35%。
六、第 5 站:顺手给基金库做个体检(145 vs 全量 1681)
既然怀疑"候选池",就把 zip 全量数据摊开看:可用于交易的 ETF 有 1681 只,我们只用了 145 只(8.6%)。
池子的主题分布很说明问题:
- 港股 57、宽基 47、美股 14、科创主题 8、其他海外 7、商品 6、贵金属股 3、日本 3;
- 港股 + 宽基 = 104 只,占 71.7%;A 股行业主题 = 0 只。
按「权益类 + 近 5 日日均成交额 ≥ 1 亿 + 跟踪指数与池内不重复」筛,找到 78 个"新暴露"指数,其中 30 个在 2021-01 及以前就有完整数据:
- 515880 通信设备(32.3 亿)、512880 券商(11.8 亿)、512480 半导体(10.7 亿)、515050 5G(8.7 亿)、512800 银行(8.4 亿)、159995 国证芯片(6.9 亿)、512400 有色(6.7 亿)、159992 创新药(6.4 亿)、515220 煤炭(6.2 亿)、512890 红利低波(5.2 亿)……另有医疗/300医药/主要消费/酒/军工/光伏/新能源车/传媒/地产/AI/非银 等。
(顺便说:这些分类问题目前对策略几乎没影响,因为只持 3 只、主题上限是 6 席,根本触发不到;但它会误导分析,而且一旦持仓数提到 5 只以上就立刻变成关键变量。)
七、第 6 站:把池子扩到 176 只试跑——结果反而更差
按体检结论,把 30 只 A 股行业基 + 1 只有色期货加进池子(145 → 176),重建分钟缓存和前复权日线,重跑 30 分钟与 60 分钟:
- 池 145 · 30min:净值 5.6832 / 年化 29.40% / 回撤 -15.89% / Calmar 1.85
- 池 176 · 30min:净值 4.5272 / 年化 25.11% / 回撤 -24.62% / Calmar 1.02
- 池 145 · 60min:5.9532 / 30.30% / -16.59% / 1.83
- 池 176 · 60min:4.6247 / 25.51% / -27.83% / 0.92
- 熔断次数差异:池 145 全程 0 次熔断,池 176 触发 4 次(2021-05、2022-05、2024-09、2026-02)。四段合计:池 145 +42.31% vs 池 176 +27.53%(-14.78pp)。A 股行业 ETF 是单行业高 beta,轮进错误行业时回撤更深 → 更早击穿 -20% → 空仓 20 天 → 错过反弹。剔除这四段后再比,只差 -2.2pp。
- 去重是顺序相关的:
build_dedup_pool按日均成交额降序、先到先得、相关性 >0.9 剔除。所以加入 515880(32.3 亿,流动性全池前列)这类标的,会把原来排在前面的标的挤出去——不是"多了一个选择",而是"换了一批候选"。
八、第 7 站:A 股行业基要快节奏——单独扫参数(此刻还是弱 T+1 口径)
既然差异来自"节奏",就单独给 30 只 A 股行业基扫了 120 组参数(eval 5/10/15/30/60 × 动量 5/10/15/20 × K 1/2/3 × 阈值 1%/2%):
- 现有参数(e30/m15/K3/1%):净值 3.722 / 年化 21.67% / 回撤 -25.39% / Calmar 0.85,只排 26/120;
- 当时的最优(e5/m10/K3/2%):净值 5.618 / 年化 29.38% / 回撤 -17.74% / Calmar 1.66。
再和主池做"双 sleeve 资金混合":相关系数只有 0.531(直接合池是 0.808,因为去重后选的东西高度重合),主 80 / A 20 时 Calmar 1.85 → 1.95,回撤 -15.89% → -15.03%。
⚠️ 注意:这一站的结论当天晚些时候被推翻了,见第十一站。这里保留当时的原始结论,方便看清"错在哪里"。
九、第 8 站:评估频率谱——越勤快越差
有人会问:既然 A 股行业基要快,那把评估频率一路提到每分钟会怎样?答案很干脆。
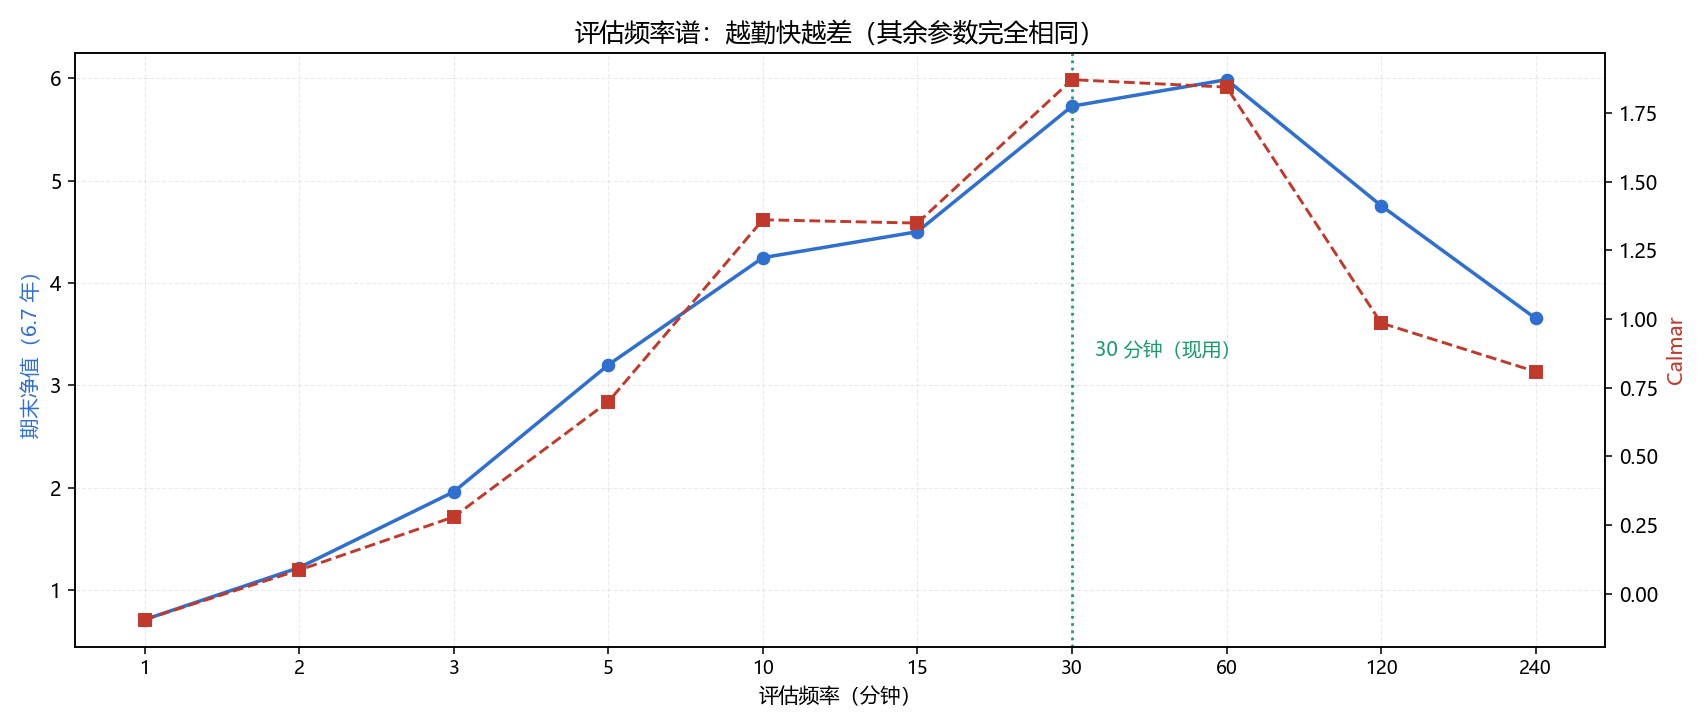
在其余参数完全相同的前提下,只改评估频率(1/2/3/5/10/15/30/60/120/240 分钟):
- 每 1 分钟:净值 0.7114、年化 -4.93%、回撤 -51.55%、调仓 24902 次;
- 每 5 分钟:3.1680、+18.66%、-27.13%;
- 每 10 分钟:4.1943、+23.70%、-17.69%;
- 每 30 分钟(现用):5.6832、+29.40%、-15.89%、Calmar 1.85;
- 每 60 分钟:5.9532、+30.30%、-16.59%、Calmar 1.83;
- 每 240 分钟(每天 1 次):3.6541、+21.20%、-26.38%。
把佣金剥掉算"毛净值"(不考虑成本的净值)后:
- 年化从 29.40% → -4.93%(-34.33pp);
- 其中毛年化从 31.31% → 2.23%(-29.08pp,占 85%);
- 佣金成本从 1.45%/年 → 7.00%/年(-5.55pp,只占 15%)。
往两个方向都更差,而且高频那侧惩罚重得多:
- 每 30 分钟 → 每天 1 次:年化 -8.2pp
- 每 30 分钟 → 每 1 分钟:年化 -34.3pp
十、第 9 站:日频版为什么差那么多?——还顺手挖出一个熔断 bug
把同一套池子在日频引擎上跑(每天强制换仓),结果差得离谱。做了控制变量分解(年化 29.40% → 11.73%,共 -17.7pp):
- 评估频率(一天 8 次 → 1~2 次,同信号):-6.5pp
- 信号口径 + 引擎实现(分钟动量 → 日线动量):-5.1pp
- 参数(动量 15 日 → 20 日,脚本默认值):-6.1pp
- 执行时点本身(09:30 / 09:45 / 14:45):约 1pp,而且不稳健
真正的杀手是 2024 年那一个点:30 分钟版 +67.8% vs 日频版 -2.8%,差 70.6pp。日频版 09-04 手里是日经 225、标普 500、纳指科技(全是海外),回撤到 -21.7% 触发熔断,然后冻结 20 个交易日到 10-11,完整错过 9 月底 A 股那波;而 30 分钟版靠持续轮动,9 月 20 日就已经切进了港股(香港证券 / 港股创新药 / 恒生科技)。
顺着这个线索查代码,发现日频引擎独有的熔断 bug:
310  hold = {}                     ← 熔断清仓
...
320  if will:                      ← will 在当日开头就算好了(那时还没熔断)
325 hold = dict(target) ← 把刚清掉的仓位原样买回来净值反推验证:用"熔断后冻结持仓"模拟,与实际净值逐日吻合到小数点后 4 位;用"空仓"假设则差得远。所以那个熔断根本没清仓,只是停止了 20 天调仓。修掉后回撤从 -32.33% 改善到 -28.6%(2021 年从 -17.29% 改善到 -12.77%)。
十一、第 10 站:混在一个账户里同时跑,到底行不行
既然两个 sleeve 的相关系数只有 0.53,那"能不能混在一个账户里同时跑、让它们互补"就成了核心问题。为此专门写了一个单账户合并引擎:一个账户、两套信号/参数、两个 sleeve,共用一份现金、共用一本 T+1 账本、账户级熔断。
关键是要把"怎么混"分成两种:
- 紧密合并:任一侧评估,都把整个账户拉回"两侧总目标";
- 松耦合:同样共用一个账户,但每次只交易刚评估过的那一侧,另一侧仓位不动。
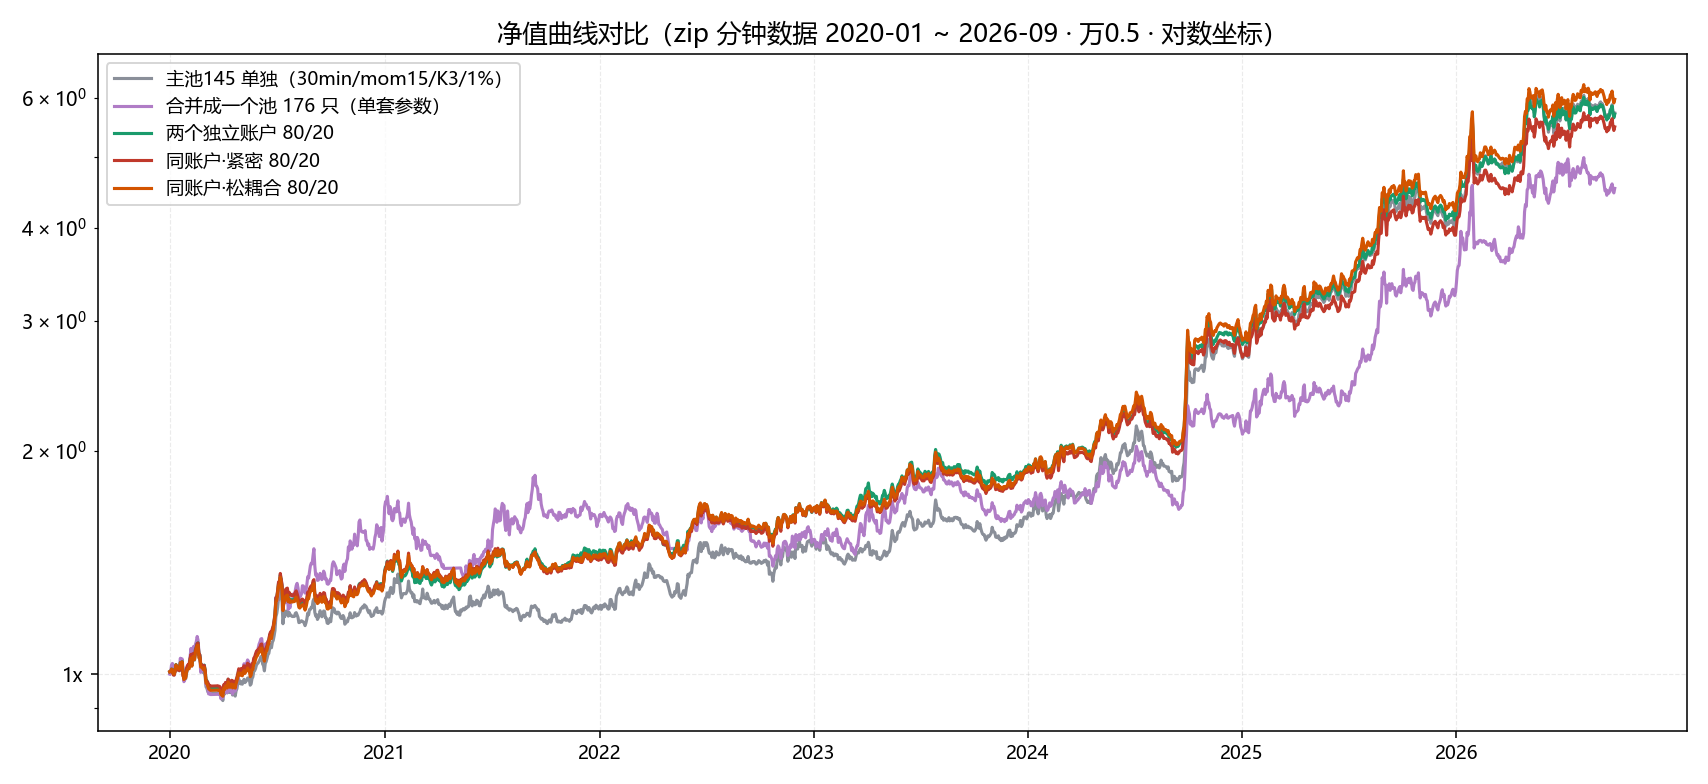
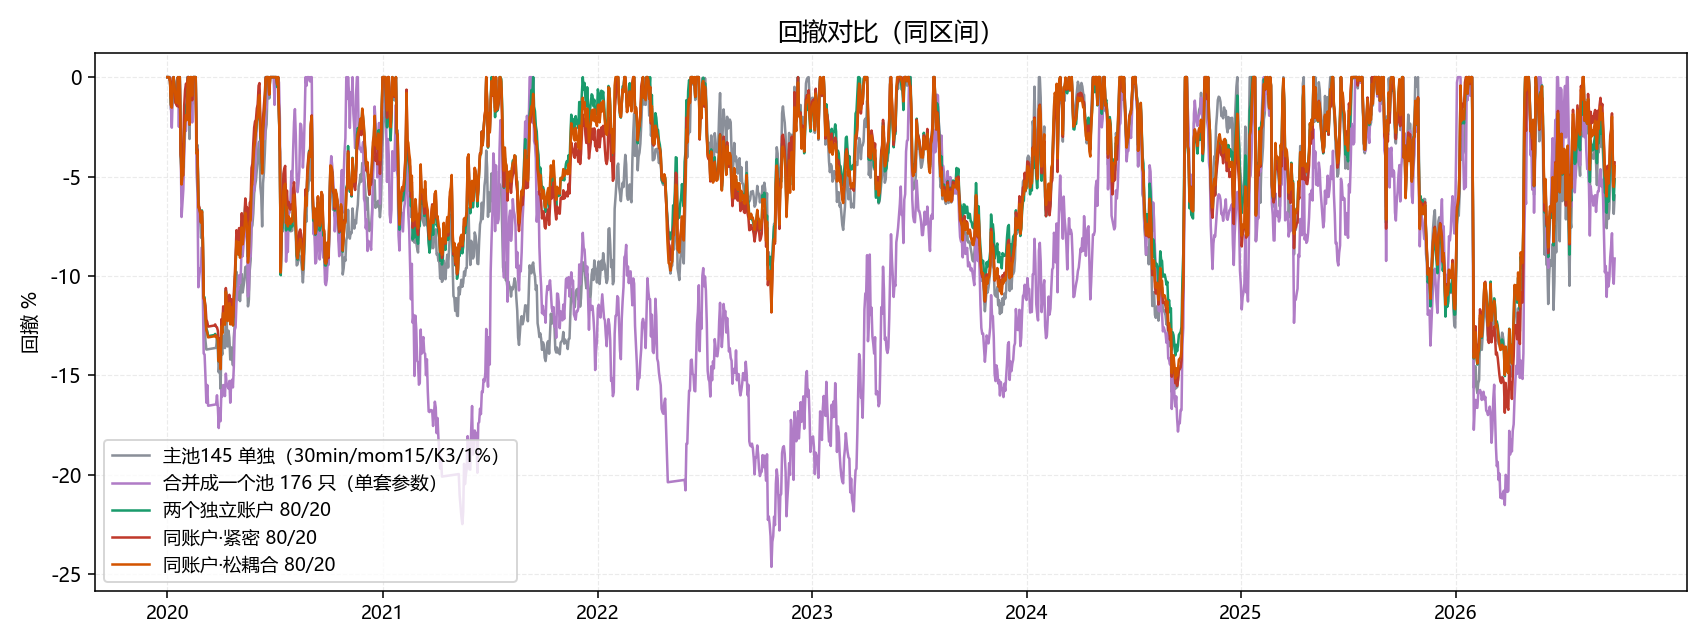
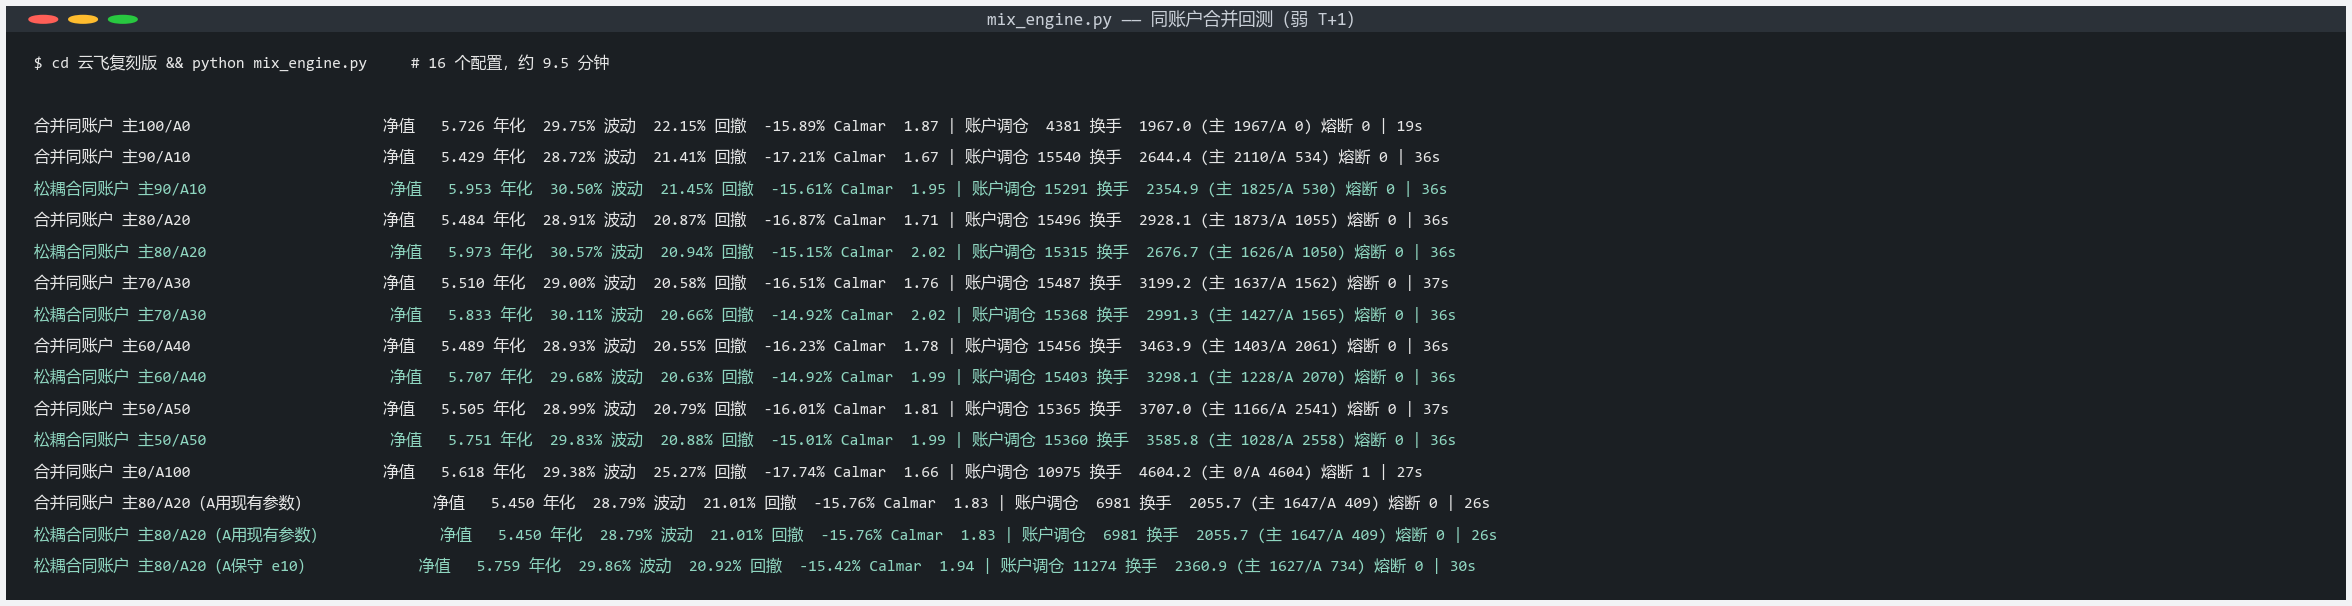
- 只跑主池 145:5.726 / 29.75% / 回撤 -15.89% / Calmar 1.87
- 只跑 A 股行业基 30:5.618 / 29.38% / -17.74% / 1.66
- 合并成一个池(176 只、单套参数):4.530 / 25.29% / -24.62% / 1.03
- 两个独立账户 80/20(各跑各的):5.704 / 29.67% / -15.03% / 1.97
- 同账户·紧密 80/20:5.484 / 28.91% / -16.87% / 1.71(比不混还差)
- 同账户·松耦合 80/20:5.973 / 30.57% / -15.15% / Calmar 2.02 ← 最优
机制很清楚:
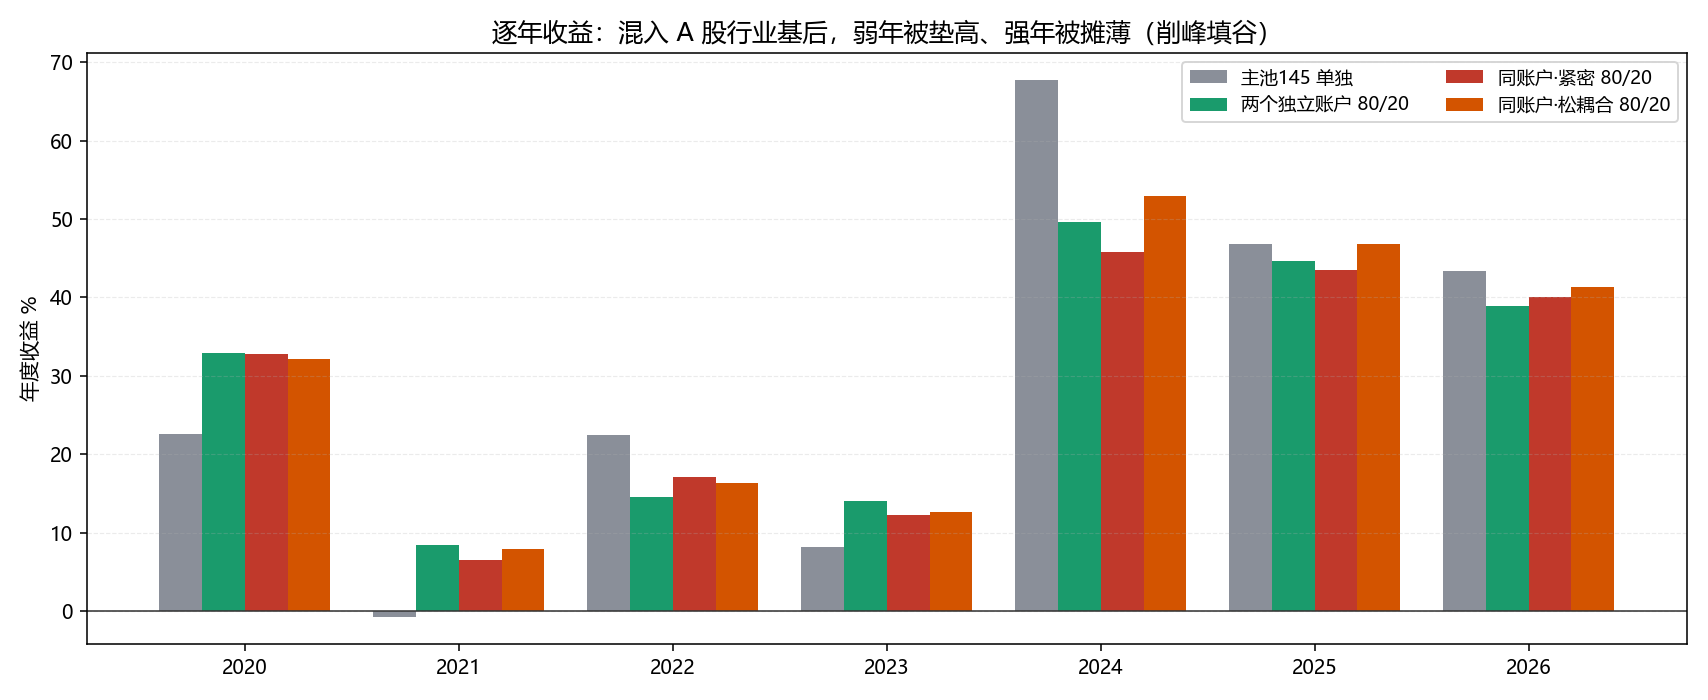
- 紧密模式下,A 侧每 5 分钟评估一次,每次都会把主池仓位一起拉回目标 → 主池换手从 1626 被推到 1873(+15%)。但多出来的佣金只值 0.19pp/年,解释不了 1.66pp/年的差距——真正的损耗是主池仓位在错误的时点被重排(被 A 侧的节奏牵着走),2024 年最明显(53.0% vs 紧密 45.8%)。
- 松耦合相对"两个独立账户"的差异是噪声型:逐日收益差累计 +4.78%、绝对差合计 152.6%、单日最大 ±1.1%,没有单一主因日,额外换手只值 0.14pp/年。
另外逐年看,混入 A 股行业基后呈现典型的削峰填谷:2021 从 -0.8% 垫到 +7.9%,2024 从 67.8% 摊到 53.0%。
中途我还写错了两次,都是自己查出来的(记下来免得再踩):
- 滞回锚点用错:第一版把"上次目标"当锚点,而离线引擎的锚点是"当前实际持仓"。后果:买入被缩量或 T+1 挡住后不会补单,残仓一直挂着——A 侧单跑只跑出 5.022(正确 5.618)、回撤 -20.55%(正确 -17.74%)。改成锚实际持仓后端点逐位复现。
- 松耦合会丢仓位:只交易一侧时,
new_hold只包含那一侧的标的,另一侧持仓被静默丢弃(等于免费清仓、下次再买回来),换手翻倍、年化掉到 24.45%。
十二、第 11 站:最后一个问题,也是当天最严重的——"测试到底有没有真的 T+1?"
有读者(其实是自己)问了一句:"这些测试是不是都是 T+1,特别是 A 股行业基?"
第一层答案:是,都开着。 两个引擎的 t1_rule=True 都是默认值,两个 sleeve 共用一本 T+1 账本,连熔断清仓都保留了当日买入的部分。
第二层答案:A 股行业基现实中确实全部是 T+1。 按真实交易规则给池子分类:
- A 股行业基 30 只:0 只 T+0,30 只 T+1(半导体、通信、券商、银行、有色、煤炭、红利、医药、军工、白酒、地产、光伏、新能源车、AI……)
- 主池 145:85 只(59%)实际是 T+0(81 只跨境 ETF + 4 只实物黄金 + 豆粕),60 只 T+1。
512400 有色金属ETF 跟踪的是有色金属股票指数、515450 标普中国A股红利低波50 名字里有"标普"但是 A 股指数——两只都是 T+1。)
第三层答案才是关键:引擎的 T+1 只锁"一轮",不锁"一天"。
代码里每次成交都把锁定表整体重建:
bought_today = {kk: inc[kk] * scale for kk in inc if ...} # 之前几次买入的锁定被清空效果上等于"买入后只要过了下一次调仓,当天就能卖"。我加了诊断计数器实测:
- A 股行业基单跑:18,882 笔卖出超出真实可卖量,超出量合计 4,780(≈ 它的全部换手 4,604);
- 主池单跑:3,578 笔 / 806;
- 松耦合 80/20:18,786 笔 / 1,434。
把 T+1 改成严格(当日买入份额当日绝不卖)重跑:
- A 股行业基 e5/m10(原"最优"):净值 5.618 → 3.346,年化 29.38% → 19.75%,回撤 -17.74% → -26.02%,Calmar 1.66 → 0.76;
- e15/m10:1.12 → 0.75;
- e30/m10:1.01 → 1.00(严格口径下最好的);
- e30/m15:0.83 → 0.35(回撤 -41.90%);
- e60/m10:1.37 → 0.78。
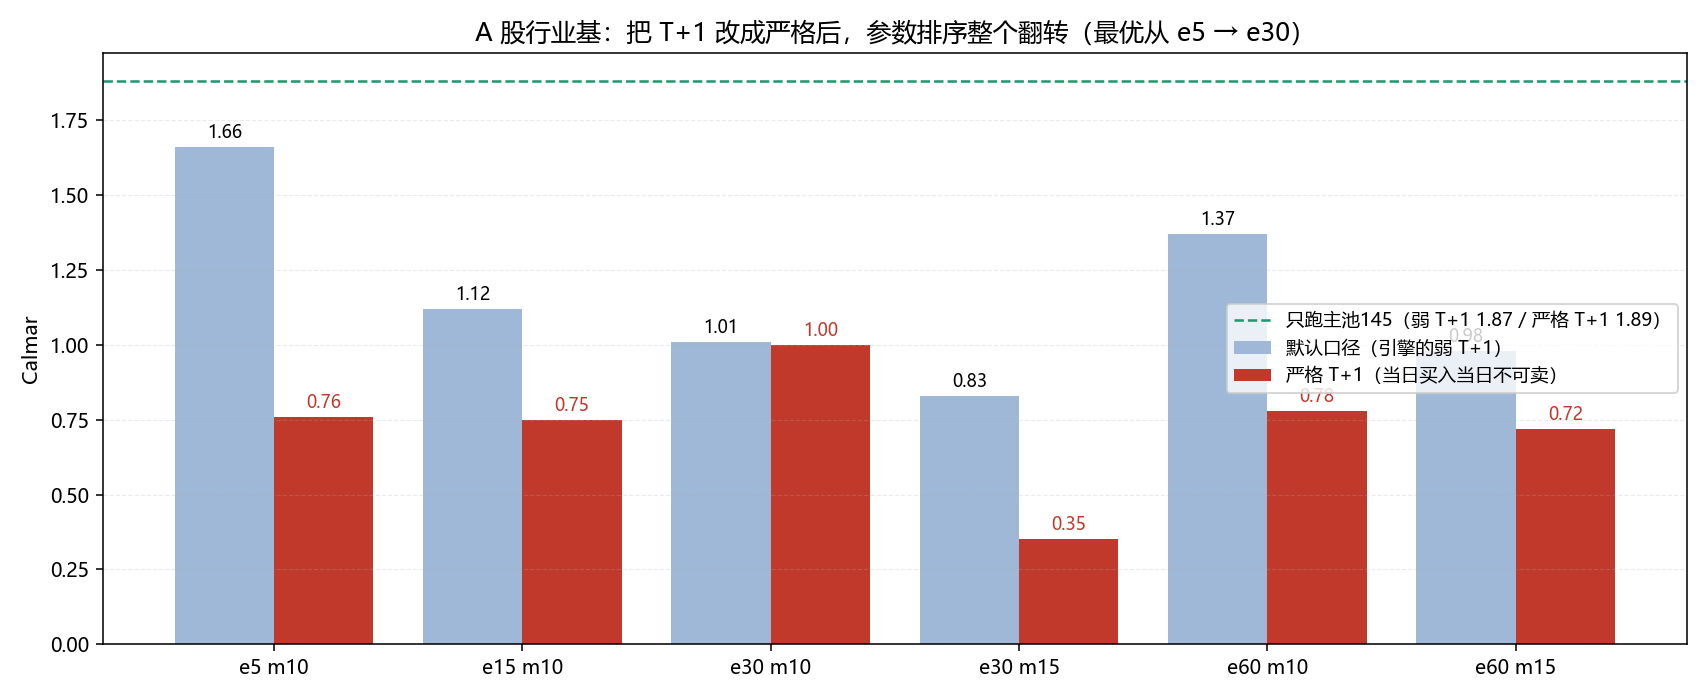
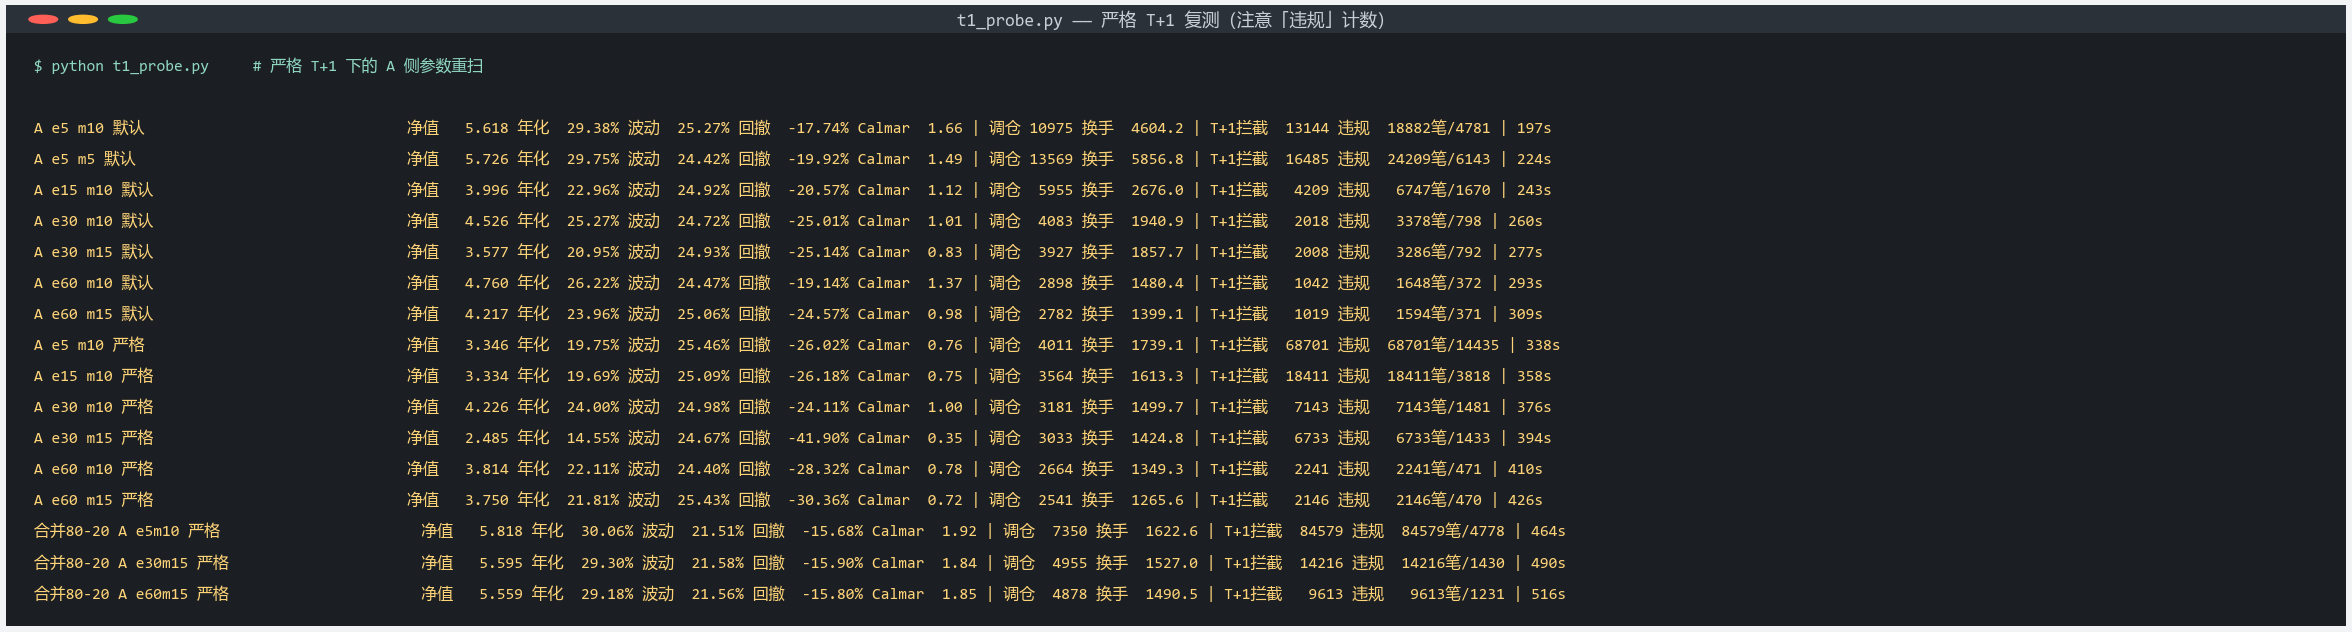
参数排序整个翻转:默认口径下"评估越快越好"(e5 最优),严格口径下"越快越差"。所以第八站那个「A 股行业基要 5~10 分钟评估」的结论作废——那是同日回转制造的假象。而且严格口径下,A 侧任何参数都打不赢主池单跑(最好 1.00 vs 主池 1.89)。
顺带两个重要发现:
- 主池在严格 T+1 下反而更好:5.726 → 6.053,年化 29.75% → 30.83%,Calmar 1.87 → 1.89,换手 1967 → 1497。说明主池根本不需要日内回转,之前的"同日买回卖回"多半是噪声交易。
- 你在跑的 QMT 版用的是严格口径(
STATE['bought_today'][code] = ... + int(quantity)是累计写法)。所以是离线回测比实盘松,不是相反——这解释了对不齐时为什么总是离线看起来更好。
- 只跑主池 145:6.053 / 30.83% / -16.34% / Calmar 1.89
- 只跑 A 股 30:3.346 / 19.75% / -26.02% / 0.76
- 两个独立账户 80/20:5.512 / 29.01% / -16.89% / 1.72
- 同账户·松耦合 80/20:5.818 / 30.06% / -15.68% / Calmar 1.92
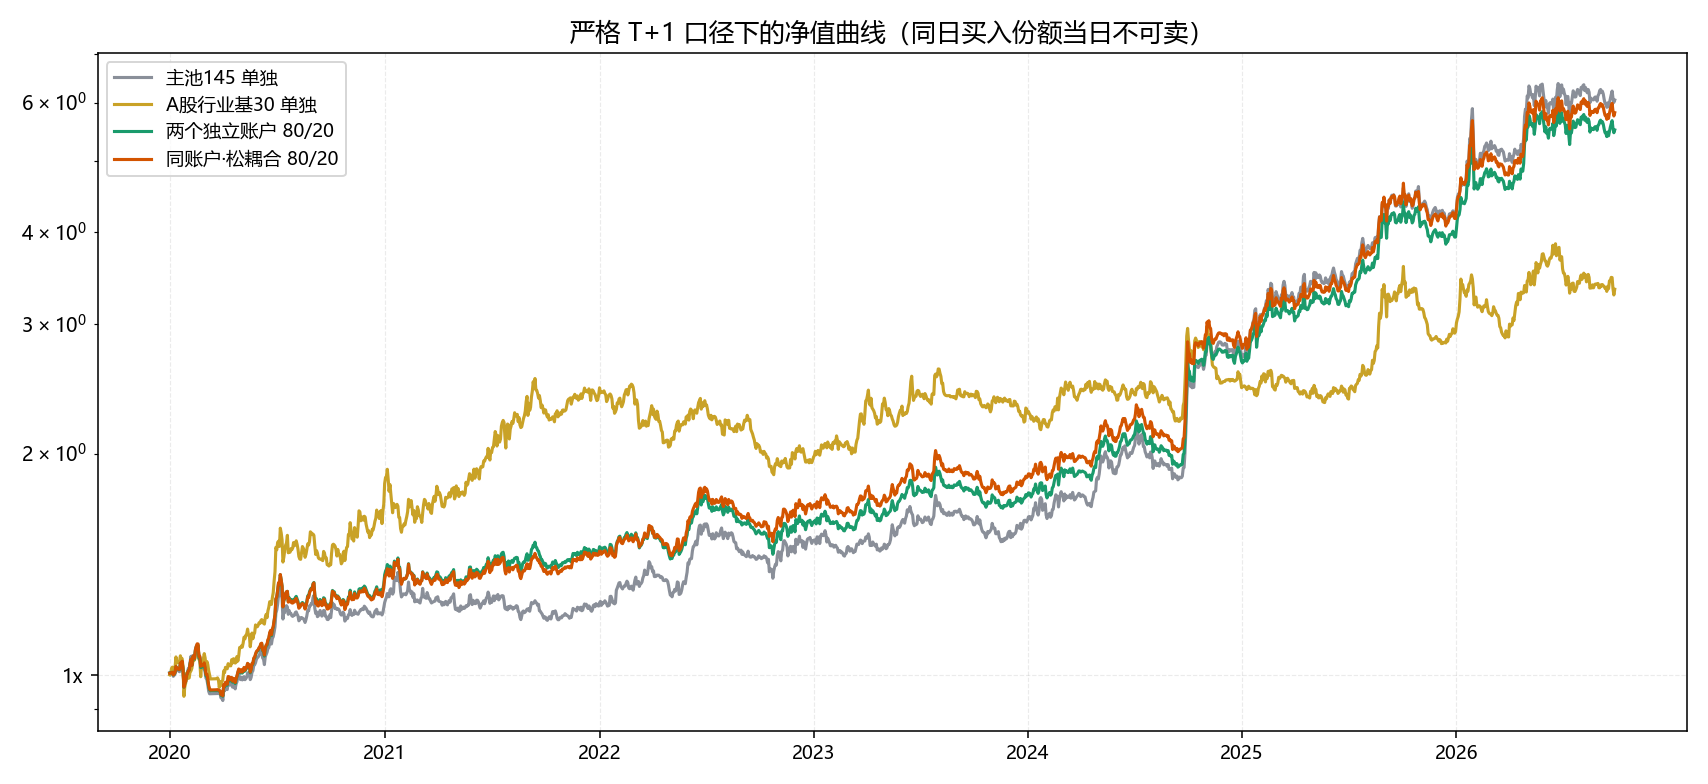
结论仍然成立(松耦合 > 主池单跑 > 两个独立账户),但要给优势打个折:这 +0.20 Calmar 主要来自 2022 一年(+7.27pp),其余年份在 ±1.7pp 内,逐日差异仍是噪声型。A 侧严格口径的逐年收益是 2020 +70.7%、2021 +40.8%、2022 -18.5%、2023 +17.5%、2024 +9.2%、2025 +16.7%、2026 +14.1%——业绩高度集中在 2020-21 两年。
所以我的判断是:A 股行业基这条线,证据强度不足以支撑"必须上",小仓位试或放弃都合理。
十三、今天踩过的坑(清单)
- QMT 取数会用 0 补行首:
count大于标的真实历史时,多出来的行是 0,不是"返回不足根数"。任何 count 相关逻辑都要防 0 行。 - 离线引擎的 T+1 是弱实现:
bought_today每次重建,等于只锁一轮。高频 sleeve 的结果会被系统性高估。 - 文件指纹进缓存键:改引擎文件会让预计算缓存全部失效重算(约 86 秒 + 36 秒),改代码前要有心理准备。
- 统计口径要跟引擎一致:净值应取曲线末值(起点约 1.008 而非 1.0),按首值归一会低估约 0.7%。
- 同一配置重复跑会抖:Python 字符串哈希随机化 → 并列动量时选股排序差异 → 净值约 ±1% 抖动。所有回测必须固定
PYTHONHASHSEED=0。 - 参数比较必须分段看:只看全区间容易被"一段好一段差"的改动骗到;要拆成两段,两段都改善的才值得采纳。
- 报结论前先验证引擎本身:这次就是引擎一处逻辑错误(熔断清仓被同日调仓撤销)让"参数稳健性"结论整盘翻掉。
十四、方法论小结(可复用的检验习惯)
- 控制变量分解:要回答"A 比 B 差多少、为什么",就把差异逐层拆开(频率 / 信号口径 / 参数 / 执行时点),每层只改一个东西。
- 端点校验:写新引擎时,让它在边界条件下(权重 1.0 或 0.0)逐位复现已有引擎的结果,否则两套数字不可比。
- 消融实验:怀疑某个标的/某段数据影响结论时,把它剔掉重跑,看差异是否被解释。
- 数据源交叉验证:同一年同策略在四个口径下差 24pp,说明"数据质量"经常比"策略细节"更决定结论。
- 前视漏洞三件套:前缀决定性、未来价格篡改、噪声地板——把未来换成完全不同的世界,历史段应毫发无损。
- 把不确定性写进结论:例如"这个数字有 ±1% 抖动""优势主要来自某一年",比给一个漂亮数字有用得多。
十五、待办
- [ ] 把离线引擎的 T+1 切到严格口径(已加开关,默认关闭),并重跑全部历史结论;
- [ ] A 股行业基这条线:在严格口径下重新评估是否继续;
- [ ] 主池 85 只 T+0 品种是否要放开日内回转(引擎现在一刀切 T+1,与 QMT 版一致,所以不放开也不会有口径差);
- [ ] QMT 里补齐池内 145 只的分钟数据到回测起点之前;
- [ ] 核对 159941 / 159509 这类定折 QDII 的复权设置。
本文由当天的日志、回测产出和核对脚本整理而成;所有数字都可用文末附件与脚本复现。
💬 评论 (0)
还没有评论,来抢沙发吧。